Contents
3.1. 올바른 알고리즘 선정 방법. 
- 목적을 고려해야 한다.
만약에 목적 값(target value)을 예측하려고 한다면 지도 학습 방법(Supervised Learning)을 살펴보고, 그렇지 않다면 비지도 학습 방법(Unsupervised Learning)을 살펴보라.
지도 학습 방법
목적 값이 이산적인 값인가?
분류 방법(Classification)목적 값이 연속적인 값인가?
회귀(Regression)
비지도 학습 방법 - 보유하고 있는 데이터를 고려해야만 한다.
속성이 명목형인가?
속성이 연속형인가?
속성내 누락된 값이 존재하는가?
왜 존재하는가?
오류 데이터(Outlier)가 존재하는가?
데이터가 이산적인 무리에 알맞은가?
군집화(Clustering)
무리에 알맞은 정도를 수치적으로 평가?밀도 추정(Density estimation)
3.2. 기계 학습 응용 프로그램 개발 단계 
- 데이터 수집
- 입력 데이터 준비
- 입력 데이터 분석
- 알고리즘 훈련
기계 학습이 이루어지는 부분.
- 알고리즘 테스트
만족스럽지 못하면 1로 돌아간다.
- 사용하기.
3.3. NumPy 라이브러리로 시작하기. 
- numPy 설치 방법.
64bit window를 사용하는 유저는 http://www.lfd.uci.edu/~gohlke/pythonlibs/#numpy에서 설치하면 됨.
- matplotlib 설치.
http://matplotlib.org/downloads.html
http://www.lfd.uci.edu/~gohlke/pythonlibs/#matplotlib 을 통해서 필요한 것을 추가로 설치해주면 된다.
Requires numpy, dateutil, pytz, pyparsing, six, and optionally pillow, pycairo, tornado, wxpython, pyside, pyqt, ghostscript, miktex, ffmpeg, mencoder, avconv, or imagemagick.
4. 2장 k-최근접 이웃 알고리즘(K-Nearest Neighbor Algorithm) 
기존에 훈련 집합이었던 예제 데이터 집합이 있다. 모든 데이터는 분류 항복 표시(labels)가 붙어 있으며, 따라서 각각의 데이터가 어떤 분류 항목으로 구분되는지 알 수 있다. 이후 분류 항목 표시가 붙어 있지 않은 새로운 데이터가 주어졌을 때, 기존의 모든 데이터와 새로운 데이터를 비교한다. 그리고 가장 유사한 데이터(가장 근접한 이웃)의 분류 항목 표시를 살펴본다. 이때 분류 항목을 이미 알고 있는 데이터 집합에서 상위 k개의 유사한 데이터를 살펴보게 된다. 마지막으로 k개의 가장 유사한 데이터들 중 다수결을 통해 새로운 데이터의 분류 항목을 결정하게 된다.
4.1.3. 준비: 수치형 값 정규화하기. 
단지 값이 크다는 이유만으로 항공 마일지리가 다른 속성보다 중요하다고 할 수 있는 것일까?
그것에 특별히 중요도를 가지지 않는한 이 속성은 다른 속성과 비슷한 중요도를 갖고 있을 것이다.
newValue = (oldValue - min) / (max - min)
그것에 특별히 중요도를 가지지 않는한 이 속성은 다른 속성과 비슷한 중요도를 갖고 있을 것이다.
newValue = (oldValue - min) / (max - min)
4.1.4. 검사: 전체 프로그램으로 분류기 검사하기. 
기계 학습에서 한 가지 공통된 작업은 알고리즘의 성능을 평가하는 것이다.
성능을 평가하는 한 가지 방법은 현재 가지고 있는 데이터의 일부분, 즉 90% 정도를 가지고 분류기의 학습에 사용하는 것이다. 그런 다음 나머지 10%의 데이터를 가지고 분류기를 검사하여, 분류기의 성능이 어느 정도인지 알아본다.
10%는 무작위로 선택.
오류율 = 잘못 분류된 데이터 개수 / 검사에 적용한 전체 데이터 개수
0 <= 오류율 <= 1
성능을 평가하는 한 가지 방법은 현재 가지고 있는 데이터의 일부분, 즉 90% 정도를 가지고 분류기의 학습에 사용하는 것이다. 그런 다음 나머지 10%의 데이터를 가지고 분류기를 검사하여, 분류기의 성능이 어느 정도인지 알아본다.
10%는 무작위로 선택.
오류율 = 잘못 분류된 데이터 개수 / 검사에 적용한 전체 데이터 개수
0 <= 오류율 <= 1
4.2.2. 필기체 번호에 kNN 적용하기 
각 이미지를 읽어서 벡터로 변환 시킨 후, kNN을 적용시키면 된다.
여기서 좀 유용하다고 여겼던 처리는 파일명을 처리하는 것.
listdir - 디렉토리 안에 있는 파일의 목록을 리스트로 넘겨주는 함수.
from os import listdir
kNN 자체가 속도가 느리기 때문에 얼마 되지 않는 데이터 양에도 시간이 꽤 걸린다. 여기서는 매 테스트마다 콘솔 출력을 해서 그런 것도 있지만. 성능 개선을 위해서는 'kD-트리'라는 것을 사용하면 된다고 함. 'kD-트리'는 kNN을 변경한 알고리즘이라고 함.
여기서 좀 유용하다고 여겼던 처리는 파일명을 처리하는 것.
listdir - 디렉토리 안에 있는 파일의 목록을 리스트로 넘겨주는 함수.
from os import listdir
kNN 자체가 속도가 느리기 때문에 얼마 되지 않는 데이터 양에도 시간이 꽤 걸린다. 여기서는 매 테스트마다 콘솔 출력을 해서 그런 것도 있지만. 성능 개선을 위해서는 'kD-트리'라는 것을 사용하면 된다고 함. 'kD-트리'는 kNN을 변경한 알고리즘이라고 함.
4.3. 요약 
kNN은 사례 기반 학습(instance-based learning)의 한 예이다.
이런 알고리즘 수행을 위해서는 주변에서 다루기 쉬운 데이터가 있어야만 함.
그리고 데이터 전체에 대해서 거리를 구해야하므로 메모리가 많이 필요하고, 속도도 느림.
또한 데이터가 어떤 구조를 갖고 있는지 알 수 없음. (왜냐하면 독립적인 각 항목에 대해서 유사한지만 판단하니까)
따라서 '평균', '모범 사례'가 어떤 것인지 알 수가 없음.
이런 알고리즘 수행을 위해서는 주변에서 다루기 쉬운 데이터가 있어야만 함.
그리고 데이터 전체에 대해서 거리를 구해야하므로 메모리가 많이 필요하고, 속도도 느림.
또한 데이터가 어떤 구조를 갖고 있는지 알 수 없음. (왜냐하면 독립적인 각 항목에 대해서 유사한지만 판단하니까)
따라서 '평균', '모범 사례'가 어떤 것인지 알 수가 없음.
5. 3장 의사결정 트리: 한 번에 하나의 속성으로 데이터 집합 분할하기. 
의사결정 트리는 데이터에서 지식을 추출하기 위해 많은 작업을 수행한다. 그리고 추출될 지식을 가지고 잘 모르는 데이터 집합을 처리할 수 있으며, 규칙 집합을 추출해 낼 수 있다.
전문가 시스템(expert systems)에서 자주 사용된다.
전문가 시스템(expert systems)에서 자주 사용된다.
- 밑에 정리된 알고리즘은 ID3 알고리즘으로 C4.5의 기반이 되는 알고리즘이라고 한다. 또한 스터디 당시에는 잘 이해가 안됬던 규칙 집합의 의미를 최근에 강연을 듣고서 알 수 있었다.
의사 결정 트리 자체는 성능이 좋지 않다고 한다. 기존에 나와있는 다른 알고리즘 SVM, ANN 등이 훨씬 성능도 좋다. 그럼에도 불구하고 의사결정 트리가 쓰이는 이유는 해석이 쉽다는 것이다. Iris Data를 예를 들어서 설명해보자.
Measurement X1, X2, X3, X4가 존재한다고 보자.
그리고 Decision Tree 알고리즘에 의해 Tree가 결정되었고, 그 모습이
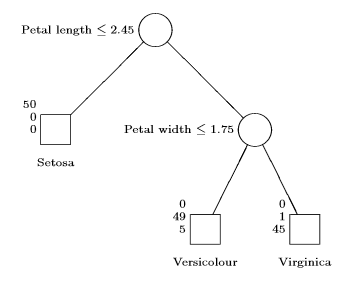
의 모습을 보이면, 우리는 트리의 분기점을 보고 규칙을 설명할 수 있다. 'Versicolour은 petal length가 2.45보다 크고, petal width가 1.75보다 작을 경우이다' 라는 식으로 가능하다.
Measurement X1, X2, X3, X4가 존재한다고 보자.
- X1 = petal length(꽃잎 길이)
- X2 = petal width(꽃잎 너비)
- X3 = sepal length(꽃받침 길이)
- X4 = sepal width(꽃받침 너비)
그리고 Decision Tree 알고리즘에 의해 Tree가 결정되었고, 그 모습이
[PNG image (6.99 KB)]
의 모습을 보이면, 우리는 트리의 분기점을 보고 규칙을 설명할 수 있다. 'Versicolour은 petal length가 2.45보다 크고, petal width가 1.75보다 작을 경우이다' 라는 식으로 가능하다.
반면에 ANN에서 위와 같은 데이터를 넣고 Classification을 돌린다고 생각하면 분류는 더 잘되나 규칙을 알 수가 없다. 전문가가 설명을 해주기 힘든 것이다. - 2015 3. 30
5.1. 트리 구조 
장점: 계산 비용이 적다. 학습된 결과를 사람이 이해하기 쉬우며 누락된 값이 있어도 처리 할 수 있다. 분류와 관련이 없는 속성이 있어도 처리 할 수 있다.
단점: 과적합(overfitting)되기 쉽다.
적용: 수치형 값, 명목형 값.
단점: 과적합(overfitting)되기 쉽다.
적용: 수치형 값, 명목형 값.
하나의 최초 의사결정(decision)을 만들어야 한다.
최초 의사결정은 데이터를 분할하는 데 영향을 주는 '속성'으로 결정된다.
최초 의사결정은 데이터를 분할하는 데 영향을 주는 '속성'으로 결정된다.
 	createBranch() pseudo code

	check if every item in the dataset is in the same class

		if so return the class label

		else

			find the best feature to split the data

			split the dataset

			create a branch node

				for each split

					call createBranch and add the result to the branch node

			return branch node
- 양자화 : 연속적인 아날로그 데이터를 처리하기 위해 중복되지 않는 여러 개의 구간으로 나누어 처리.
데이터를 어떻게 분할하고, 데이터 분할을 언제 멈추어야 하는가?
ID3 Algorithm
5.1.1. 정보 이득 
데이터 집합을 분할하기 위한 한 가지 방법을 선정하고 체계적이지 못한 데이터를 체계적으로 만든다.
다루기 어려운 데이터를 조직화하기 위한 방법 중 한 가지는 정보를 측정하는 것. 정보 이론을 사용하면 데이터를 분할하기 전과 후의 정보를 측정할 수 있다.
데이터를 분할하기 전과 후의 변화를 정보 이득(information gain)이라고 한다.
정보 이득이 가장 높은 속성을 가지고 분할하는 것이 가장 좋은 선택이다.
다루기 어려운 데이터를 조직화하기 위한 방법 중 한 가지는 정보를 측정하는 것. 정보 이론을 사용하면 데이터를 분할하기 전과 후의 정보를 측정할 수 있다.
데이터를 분할하기 전과 후의 변화를 정보 이득(information gain)이라고 한다.
정보 이득이 가장 높은 속성을 가지고 분할하는 것이 가장 좋은 선택이다.
섀넌 엔트로피(Shannon entropy)
http://www.aistudy.com/control/information_theory.htm
http://ko.wikipedia.org/wiki/%EC%A0%95%EB%B3%B4_%EC%97%94%ED%8A%B8%EB%A1%9C%ED%94%BC
http://www.aistudy.com/control/information_theory.htm
http://ko.wikipedia.org/wiki/%EC%A0%95%EB%B3%B4_%EC%97%94%ED%8A%B8%EB%A1%9C%ED%94%BC
정보량이란 그 사상에 대해 모르는 정도에 대한 양이라고 할 수 있다. 이 것을 엔트로피라고 한다.
e.g. 16개의 카드에서 고른 1장의 카드를 알아맞추는 경우
e.g. 16개의 카드에서 고른 1장의 카드를 알아맞추는 경우
16 -> 8 -> 4 -> 2-> 1
4번의 질문을 통해서 1장의 카드를 알아 맞출수 있다.
이 정보량을 확률적 방식으로 표현함.4번의 질문을 통해서 1장의 카드를 알아 맞출수 있다.
=> 질문에 대한 대답이 네번 필요하다. -> 정보가 4개가 필요하다.
데이터 집합을 기반으로 섀넌 엔트로피를 적용시켰을 경우, 몇 번의 질문을 통해서 의사 결정이 가능한지를 알 수 있음.
https://courses.cs.washington.edu/courses/cse455/10au/notes/InfoGain.pdf 설명이 쉽게 잘 되있다.
5.1.2. 데이터 집합 분할하기 
엔트로피를 측정하고 데이터 집합을 분할하며, 분할된 집합의 엔트로피를 측정하고 분할이 올바르게 되었는지를 확인해야 한다.
각 속성으로 데이터 집합을 분할했을 때, 엔트로피를 측정하고 가장 엔트로피가 작게 나오는 속성을 찾는 것.
알아두면 좋을 것이 하나 있다.
각 속성으로 데이터 집합을 분할했을 때, 엔트로피를 측정하고 가장 엔트로피가 작게 나오는 속성을 찾는 것.
알아두면 좋을 것이 하나 있다.
set이라는 것인데, 집합이다.
choose_best_feature_to_split 함수에서 set을 사용하는데, 어떤 속성에서 나올 수 있는 모든 값을 추출해내는데 쓸 수 있다.
choose_best_feature_to_split 함수에서 set을 사용하는데, 어떤 속성에서 나올 수 있는 모든 값을 추출해내는데 쓸 수 있다.
5.1.3. 재귀적으로 트리 만들기 
더 이상 분할할 속성이 없거나 하나의 가지에 있는 모든 사례가 전부 같은 분류 항목일 때 멈추게 할 것이다.
여기서 트리를 만드는 코드가 굉장히 큰 도움이 될 만한 요소가 많다.
의사 결정 트리를 dictionary로 구현한다. (혁준이형의 말에 따르면 이런 방식은 JavaScript에서 많이 사용된다고 한다.)
의사 결정 트리를 dictionary로 구현한다. (혁준이형의 말에 따르면 이런 방식은 JavaScript에서 많이 사용된다고 한다.)
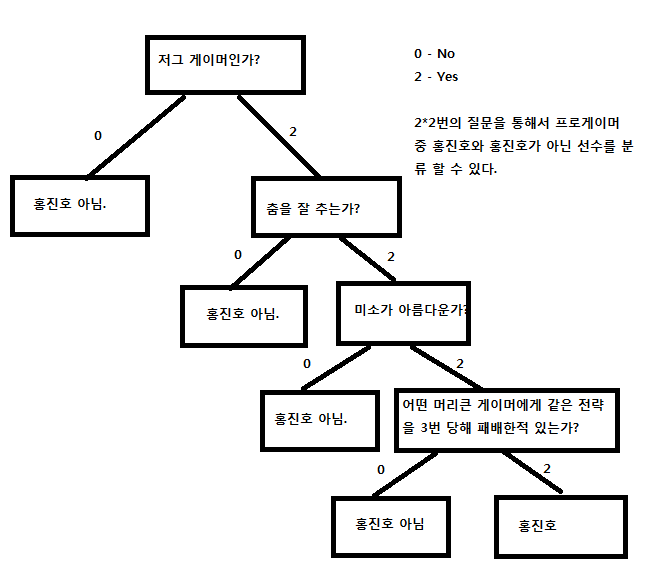
예를 들어 의사 결정 트리가 다음과 같다고 하자.
[PNG image (16.77 KB)]
{'저그 게이머인가?' : {0: '홍진호 아님', 2: {'춤을 잘 추는가?': {0: '홍진호 아님', 2: {'미소가 아름다운가?':{0: '홍진호 아님', 2:{'어떤 머리큰 게이머에게 똑같은 전략을 3번 당해 패배한적 있는가?':{0: '홍진호 아님', 2:'홍진호'}}}}}
}}}이런 식으로 Dictionary가 만들어 질 것이다.
구현 코드는 다음과 같다.
 def create_tree(data_set, labels):
    class_list = [example[-1] for example in data_set]
    if class_list.count(class_list[0]) == len(class_list):
        return class_list[0]
    if len(data_set[0]) == 1:
        return majority_cnt(class_list)
    best_feat = choose_best_feature_to_split(data_set)
    best_feat_label = labels[best_feat]
    my_tree = {best_feat_label: {}} #서브 트리의 루트를 만들고,
    del(labels[best_feat])
    feat_values = [example[best_feat] for example in data_set]
    unique_values = set(feat_values)
    for value in unique_values: #가지를 뻗어나가는 과정이다.
        sub_labels = labels[:]
        my_tree[best_feat_label][value] = create_tree(split_data_set(data_set, best_feat, value), sub_labels)

    return my_tree